프로그래밍에서 여러 데이터를 저장할 때 가장 먼저 접하는 자료구조 중 하나는 배열(Array)이다.
배열은 데이터를 순서대로 관리하고, 원하는 위치의 데이터에 빠르게 접근할 수 있는 대표적인 선형 자료구조다.
Python을 공부할 때 자주 사용하는 리스트(List) 역시 배열과 밀접한 관계가 있다.
그런데 배열은 어떤 원리로 데이터에 빠르게 접근할 수 있을까? 그리고 리스트 중간에 데이터를 삽입하거나 삭제하는 작업은 왜 상대적으로 느릴까?
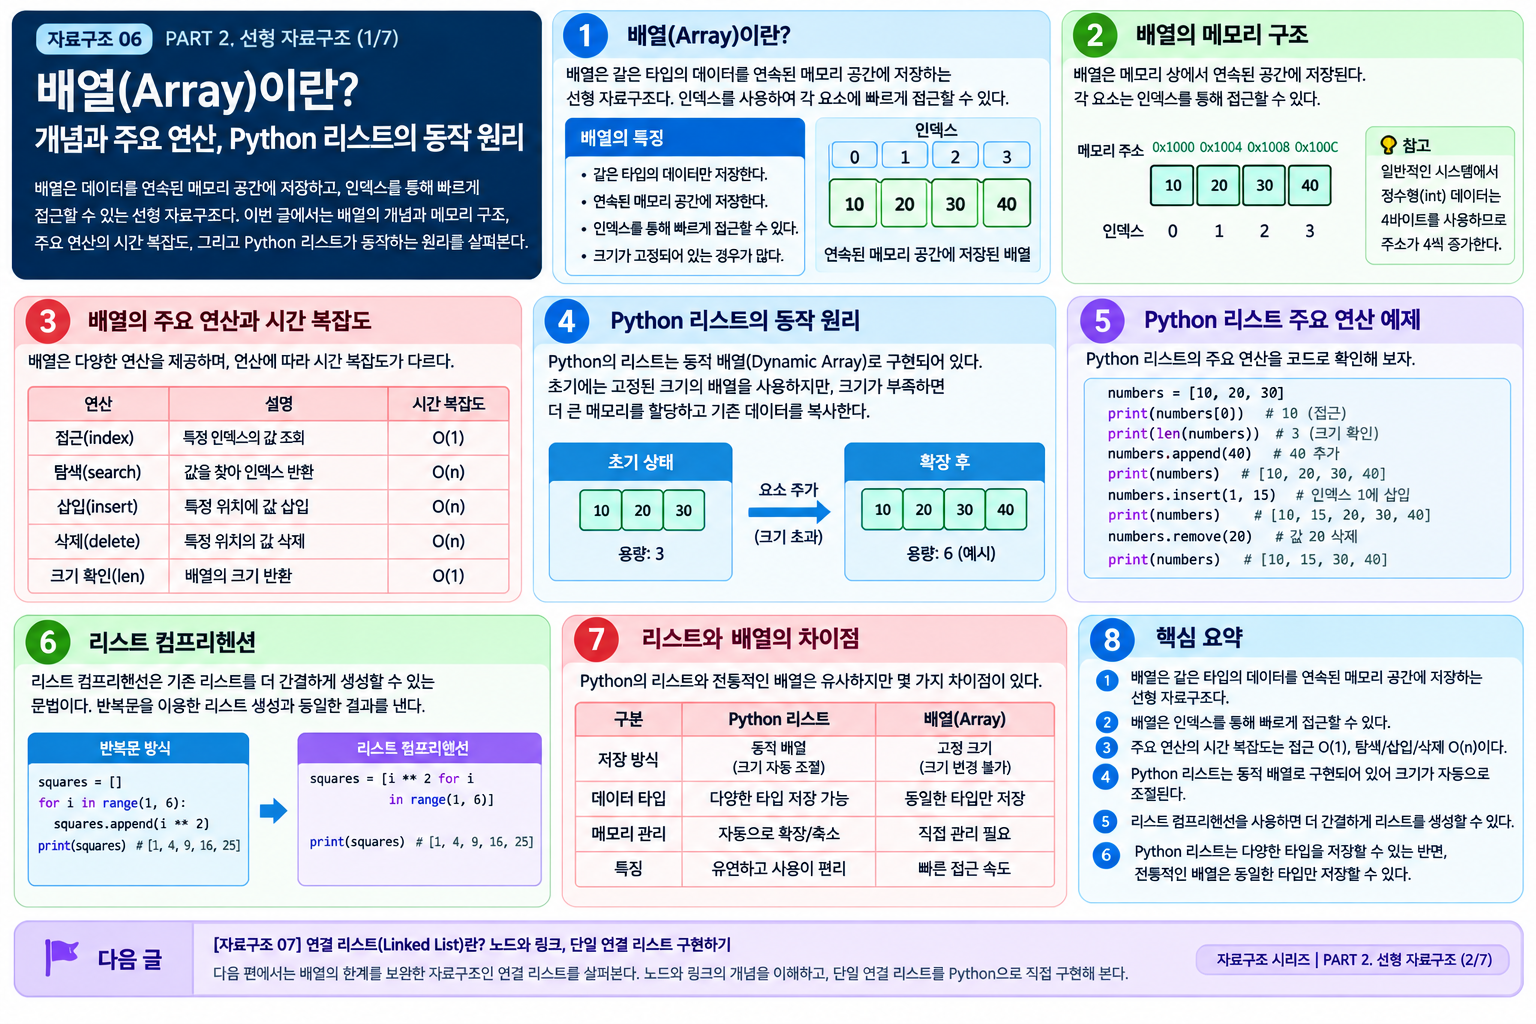
이번 글에서는 배열의 기본 개념, 메모리 구조, 주요 연산의 시간 복잡도, Python 리스트의 동작 원리를 알아본다.
1. 배열(Array)이란?
배열(Array) 은 여러 데이터를 일정한 순서에 따라 저장하고, 인덱스(Index)를 이용하여 각 요소에 접근할 수 있는 자료구조다.
전통적인 배열은 일반적으로 동일한 자료형의 요소를 연속된 메모리 공간에 저장한다.
예를 들어 다음과 같은 정수 배열을 생각해 보자.
인덱스     0    1    2    3    4
         ┌────┬────┬────┬────┬────┐
데이터   │ 10 │ 20 │ 30 │ 40 │ 50 │
         └────┴────┴────┴────┴────┘
배열의 첫 번째 요소는 인덱스 0에 위치하고, 마지막 요소는 인덱스 4에 위치한다.
일반적인 배열 기반 자료구조는 이러한 인덱스를 사용하여 특정 위치의 요소에 빠르게 접근할 수 있다.
1.1. 배열의 주요 특징
배열에는 다음과 같은 특징이 있다.
- 각 요소에 인덱스가 부여된다.
- 요소들이 순서에 따라 저장된다.
- 전통적인 배열은 동일한 크기의 요소를 연속된 메모리 공간에 저장한다.
- 인덱스를 이용한 접근이 효율적이다.
- 중간에 요소를 삽입하거나 삭제할 때 다른 요소들을 이동시켜야 할 수 있다.
전통적인 고정 크기 배열은 생성 후 크기를 변경하기 어렵다는 특징도 있다.
반면 Python 리스트처럼 동적 배열을 기반으로 구현된 자료구조는 필요에 따라 저장 공간을 확장할 수 있다.
2. 배열의 메모리 구조와 동작 원리
배열의 가장 중요한 특징 중 하나는 인덱스를 이용한 빠른 접근이다.
이러한 특징을 이해하기 위해 배열이 메모리에 저장되는 방식을 살펴보자.
2.1. 연속된 메모리 공간
전통적인 배열은 같은 크기의 요소들을 연속된 메모리 공간에 저장한다.
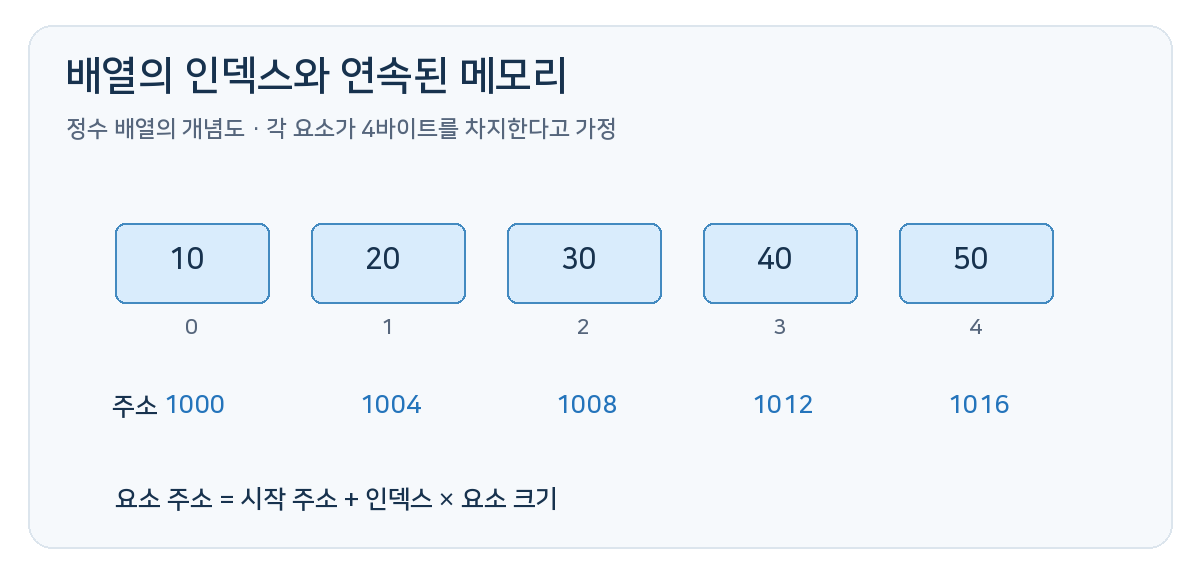
예를 들어 정수 하나가 4바이트를 차지하고, 배열의 시작 주소가 1000이라고 가정해 보자.
각 요소의 메모리 주소는 다음과 같이 표현할 수 있다.
인덱스값시작 주소
| 0 | 10 | 1000 |
| 1 | 20 | 1004 |
| 2 | 30 | 1008 |
| 3 | 40 | 1012 |
| 4 | 50 | 1016 |
배열의 각 요소가 같은 크기를 차지하므로 인덱스를 이용하여 원하는 요소의 주소를 계산할 수 있다.
일반적인 계산식은 다음과 같다.
요소 주소 = 시작 주소 + (인덱스 × 요소 크기)
예를 들어 인덱스 3의 요소는 다음과 같이 계산한다.
1000 + (3 × 4) = 1012
배열의 앞에서부터 요소를 하나씩 확인하지 않아도 특정 위치의 주소를 바로 계산할 수 있다.
따라서 배열의 인덱스 접근은 일반적으로 O(1)의 시간 복잡도를 가진다.
단, 이 예시는 전통적인 정수 배열의 메모리 구조를 설명하기 위한 것이다. Python 리스트는 정수 객체 자체를 이러한 방식으로 연속 저장하는 것은 아니다.
2.2. Python 리스트의 메모리 구조
Python의 리스트는 여러 객체에 대한 참조를 순서대로 저장하는 자료구조다.
대표적인 Python 구현인 CPython에서 리스트는 객체 참조들이 연속적으로 배치된 동적 배열을 기반으로 구현된다.
numbers = [10, 20, 30, 40]이 코드를 실행하면 리스트가 생성되고, 리스트의 각 위치에는 해당 정수 객체에 대한 참조가 저장된다.
따라서 Python 리스트에는 서로 다른 자료형의 객체도 함께 저장할 수 있다.
data = [10, "Python", 3.14, True]

print(data[0])  # 10
print(data[1])  # Python
전통적인 배열과 달리 Python 리스트에서는 모든 요소가 동일한 자료형일 필요는 없다.
또한 CPython 리스트에서 연속적으로 저장되는 것은 객체 자체가 아니라 객체를 가리키는 참조라는 점이 중요하다.
3. 배열의 주요 연산과 시간 복잡도
배열에서는 접근, 탐색, 삽입, 삭제, 수정 등의 연산을 수행할 수 있다.
각 연산은 동작 방식에 따라 서로 다른 시간 복잡도를 가진다.
3.1. 접근(Access)
접근은 특정 인덱스에 저장된 데이터를 확인하는 작업이다.
numbers = [10, 20, 30, 40, 50]

print(numbers[2])  # 30
배열의 인덱스를 사용하면 데이터의 개수와 관계없이 특정 위치의 요소에 바로 접근할 수 있다.
시간 복잡도: O(1)
3.2. 탐색(Search)
탐색은 배열에 원하는 값이 존재하는지 확인하는 작업이다.
numbers = [10, 20, 30, 40, 50]

target = 40

for i in range(len(numbers)):
    if numbers[i] == target:
        print(i)
        break
정렬되어 있지 않은 배열에서 특정 값을 찾으려면 일반적으로 요소들을 차례대로 비교해야 한다.
최악의 경우 배열의 모든 요소를 확인해야 하므로 시간 복잡도는 O(n)이다.
시간 복잡도: O(n)
단, 정렬된 배열에서는 이진 탐색을 활용하여 O(log n)에 검색할 수도 있다.
3.3. 삽입(Insertion)
삽입은 배열의 특정 위치에 새로운 요소를 추가하는 작업이다.
numbers = [10, 20, 30, 40]

numbers.insert(1, 15)

print(numbers)
# [10, 15, 20, 30, 40]
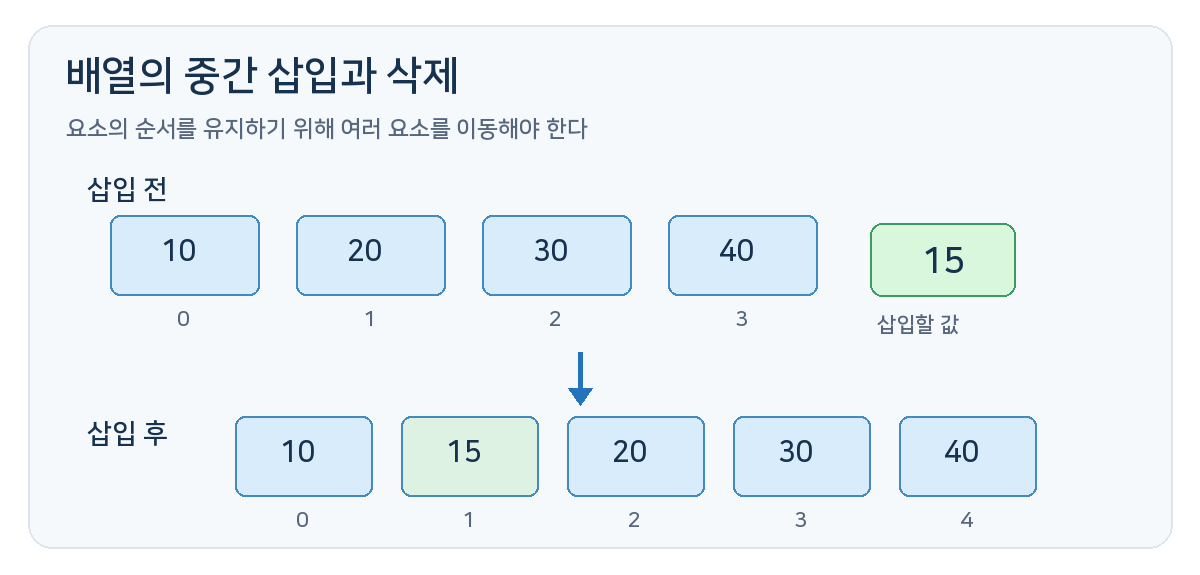
인덱스 1에 15를 삽입하면 기존의 20, 30, 40이 한 칸씩 오른쪽으로 이동한다.
삽입 전
[10, 20, 30, 40]

15를 인덱스 1에 삽입

삽입 후
[10, 15, 20, 30, 40]
배열의 앞부분에 삽입할수록 이동해야 하는 요소가 많아질 수 있다.
따라서 중간이나 앞에 삽입하는 작업은 최악의 경우 O(n)의 시간 복잡도를 가진다.
시간 복잡도: O(n)
다만 Python 리스트의 맨 뒤에 추가하는 append()는 분할 상환 O(1)에 수행된다.
3.4. 삭제(Deletion)
삭제는 특정 위치의 요소를 제거하는 작업이다.
numbers = [10, 20, 30, 40, 50]

numbers.pop(1)

print(numbers)
# [10, 30, 40, 50]
인덱스 1에 있던 20이 삭제되면 뒤에 있던 30, 40, 50이 한 칸씩 왼쪽으로 이동한다.
이처럼 배열 중간의 요소를 삭제할 때는 남은 요소를 이동시켜야 할 수 있다.
따라서 최악의 경우 시간 복잡도는 O(n)이다.
시간 복잡도: O(n)
반면 Python 리스트에서 마지막 요소를 제거하는 pop()은 일반적으로 O(1)이다.
3.5. 수정(Update)
수정은 기존 인덱스의 요소를 다른 값으로 변경하는 작업이다.
numbers = [10, 20, 30]

numbers[1] = 100

print(numbers)
# [10, 100, 30]
인덱스를 알고 있다면 해당 위치에 바로 접근하여 저장된 객체 참조를 변경할 수 있다.
시간 복잡도: O(1)
3.6. 주요 연산 정리
연산Python 예시시간 복잡도
| 인덱스 접근 | arr[i] | O(1) |
| 인덱스 수정 | arr[i] = x | O(1) |
| 순차 탐색 | x in arr | O(n) |
| 맨 뒤 삽입 | arr.append(x) | 분할 상환 O(1) |
| 중간 삽입 | arr.insert(i, x) | O(n) |
| 맨 뒤 삭제 | arr.pop() | O(1) |
| 중간 삭제 | arr.pop(i) | O(n) |
| 길이 확인 | len(arr) | O(1) |
시간 복잡도는 데이터의 개수와 연산 위치에 따라 달라질 수 있다.
4. Python 리스트의 동작 원리
Python의 리스트는 일반적인 고정 크기 배열과 달리 크기를 동적으로 변경할 수 있다.
numbers = [10, 20, 30]

numbers.append(40)
numbers.append(50)

print(numbers)
# [10, 20, 30, 40, 50]
리스트의 크기가 자동으로 증가하는 것처럼 보이지만, 내부적으로는 저장 공간을 관리하는 과정이 필요하다.
4.1. 동적 배열(Dynamic Array)
동적 배열은 저장할 요소의 개수가 증가하면 필요한 저장 공간을 확장할 수 있는 배열 기반 자료구조다.
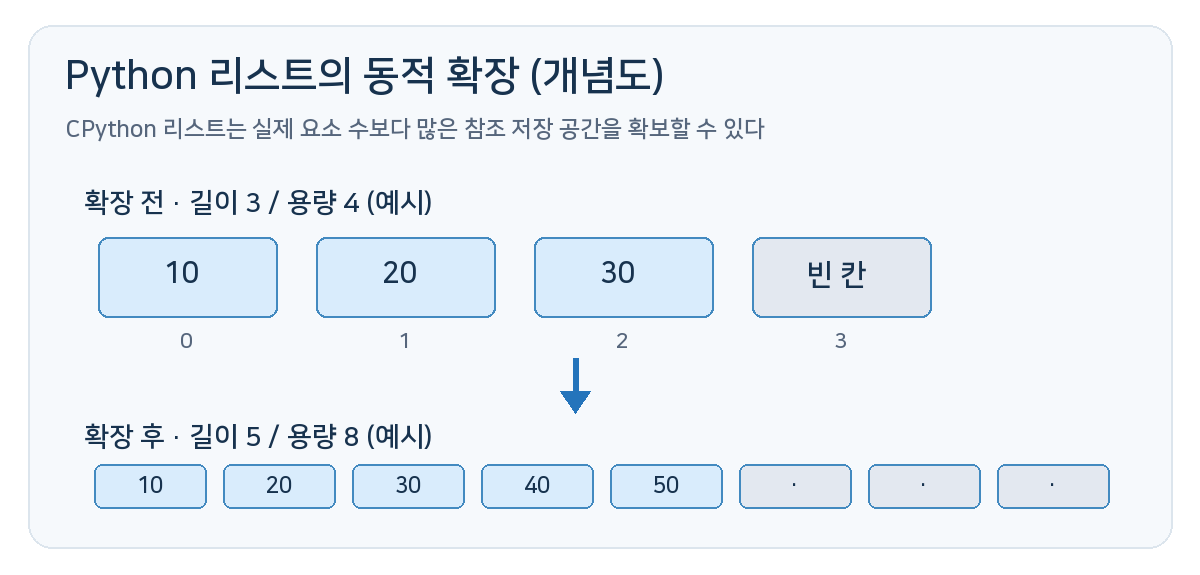
CPython의 리스트는 저장된 요소의 개수보다 더 많은 공간을 미리 확보하는 방식을 사용한다.
예를 들어 요소가 3개인 리스트가 있다고 가정해 보자.
현재 요소 수: 3
확보된 공간: 5칸

[10][20][30][  ][  ]
이 상태에서는 빈 공간이 있으므로 새로운 요소를 추가할 때 저장 공간을 다시 확보하지 않아도 된다.
append(40)

[10][20][30][40][  ]
하지만 확보된 공간이 모두 사용되면 더 큰 저장 공간이 필요하다.
이때 내부 배열의 크기를 변경하거나, 새로운 저장 공간을 확보한 뒤 기존 객체 참조를 옮길 수 있다.
기존 객체 자체를 모두 새로 복사하는 것은 아니다.
4.2. 리스트의 길이와 용량
리스트를 이해할 때는 길이(Length)와 용량(Capacity)을 구분할 필요가 있다.
- 길이: 실제 저장된 요소의 개수
- 용량: 내부적으로 확보된 저장 공간에 담을 수 있는 요소의 개수
Python의 len() 함수는 리스트의 길이를 반환한다.
numbers = [10, 20, 30]

print(len(numbers))  # 3
다만 Python 리스트는 내부 용량을 확인하는 표준 공개 메서드를 제공하지 않는다.
CPython에서는 내부 구현에 따라 여유 공간을 확보하지만, 정확한 확장 방식과 용량은 Python 버전에 따라 달라질 수 있다.
4.3. append()가 빠른 이유
리스트에 여유 공간이 있다면 새로운 요소를 마지막 위치에 추가하기만 하면 된다.
이 작업은 O(1)에 수행할 수 있다.
하지만 내부 공간이 부족하면 저장 공간을 확장하는 작업이 발생할 수 있으며, 이때는 O(n)의 비용이 들 수 있다.
그럼에도 여러 번의 append()를 연속해서 수행하는 전체 비용을 분석하면 각 삽입 연산의 분할 상환 시간 복잡도는 O(1)이다.
이를 분할 상환 분석(Amortized Analysis) 이라고 한다.
5. Python으로 배열 연산 구현하기
Python 리스트를 이용하여 배열의 주요 연산을 직접 구현해 보자.
5.1. 순차 탐색 구현
def linear_search(arr, target):
    for i in range(len(arr)):
        if arr[i] == target:
            return i

    return -1


numbers = [10, 20, 30, 40, 50]

print(linear_search(numbers, 30))  # 2
print(linear_search(numbers, 60))  # -1
리스트를 처음부터 끝까지 확인하여 목표값을 찾는다.
최악의 경우 모든 요소를 확인하므로 시간 복잡도는 O(n)이다.
5.2. 리스트 중간에 직접 삽입하기
이번에는 insert()를 사용하지 않고 요소 이동 과정을 직접 구현해 보자.
def insert_at(arr, index, value):
    if index < 0 or index > len(arr):
        raise IndexError("잘못된 인덱스")

    arr.append(None)

    for i in range(len(arr) - 1, index, -1):
        arr[i] = arr[i - 1]

    arr[index] = value


numbers = [10, 20, 30, 40]

insert_at(numbers, 1, 15)

print(numbers)
# [10, 15, 20, 30, 40]
먼저 리스트 맨 뒤에 공간을 하나 추가한다.
그다음 삽입 위치부터 뒤에 있는 요소들을 오른쪽으로 한 칸씩 이동시킨다.
마지막으로 삽입할 값을 해당 위치에 저장한다.
최악의 경우 n개의 요소를 이동시켜야 하므로 시간 복잡도는 O(n)이다.
5.3. 특정 위치의 요소 직접 삭제하기
def delete_at(arr, index):
    if index < 0 or index >= len(arr):
        raise IndexError("잘못된 인덱스")

    removed = arr[index]

    for i in range(index, len(arr) - 1):
        arr[i] = arr[i + 1]

    arr.pop()

    return removed


numbers = [10, 20, 30, 40, 50]

print(delete_at(numbers, 1))  # 20
print(numbers)                 # [10, 30, 40, 50]
삭제할 요소를 먼저 저장한 후, 뒤에 있는 요소들을 왼쪽으로 한 칸씩 이동시킨다.
마지막에는 중복으로 남은 맨 뒤 요소를 제거한다.
최악의 경우 시간 복잡도는 O(n)이다.
6. 배열의 장단점과 활용 상황
6.1. 장점
첫째, 인덱스를 이용한 접근이 빠르다.
특정 위치의 데이터를 O(1)에 조회할 수 있다.
둘째, 순서가 있는 데이터를 관리하기 편리하다.
학생 성적, 날짜별 온도, 좌표 데이터 등 순서가 중요한 데이터를 저장할 수 있다.
셋째, 반복문과 함께 사용하기 쉽다.
인덱스를 순회하면서 모든 요소를 확인하거나 수정할 수 있다.
6.2. 단점
첫째, 중간 삽입과 삭제가 비효율적일 수 있다.
데이터의 순서를 유지하려면 다른 요소들을 이동시켜야 한다.
둘째, 동적 배열에서는 용량 확장 비용이 발생할 수 있다.
저장 공간이 부족해지면 내부 배열을 확장하는 과정이 필요하다.
셋째, 삽입과 삭제가 빈번한 상황에서는 다른 자료구조가 유리할 수 있다.
예를 들어 맨 앞에서 요소를 반복적으로 삽입하거나 제거해야 한다면 Python 리스트보다 collections.deque가 적합할 수 있다.
6.3. 활용 상황
배열은 다음과 같은 상황에서 유용하다.
- 데이터의 순서를 유지해야 하는 경우
- 인덱스를 이용해 특정 위치에 자주 접근하는 경우
- 데이터의 개수가 많고 전체 요소를 순회해야 하는 경우
- 중간 삽입과 삭제보다 조회 연산이 중요한 경우
7. 코딩 테스트에서 배열 활용하기
배열은 코딩 테스트에서 매우 자주 등장하는 자료구조다.
대표적으로 누적 합, 구간 탐색, 투 포인터, 슬라이딩 윈도우 등의 알고리즘에서 활용된다.
7.1. 예제 1 — 두 수의 합
정수 리스트에서 합이 목표값이 되는 서로 다른 두 요소의 인덱스를 찾는 문제를 생각해 보자.
def two_sum(numbers, target):
    for i in range(len(numbers)):
        for j in range(i + 1, len(numbers)):
            if numbers[i] + numbers[j] == target:
                return [i, j]

    return []


numbers = [2, 7, 11, 15]

print(two_sum(numbers, 9))  # [0, 1]
이 코드는 배열의 인덱스를 이용하여 서로 다른 두 요소를 선택한다.
이중 반복문을 사용하므로 최악의 경우 시간 복잡도는 O(n²)이다.
이 문제는 해시 테이블을 활용하면 평균 O(n)에 해결할 수도 있다.
7.2. 예제 2 — 누적 합
배열의 특정 구간에 있는 요소들의 합을 여러 번 계산해야 하는 상황을 생각해 보자.
매번 구간의 모든 요소를 더하면 구간 길이에 비례하는 시간이 필요하다.
하지만 누적 합 배열을 미리 만들면 구간 합을 O(1)에 계산할 수 있다.
numbers = [1, 2, 3, 4, 5]

prefix = [0]

for number in numbers:
    prefix.append(prefix[-1] + number)

print(prefix)
# [0, 1, 3, 6, 10, 15]
예를 들어 인덱스 1부터 3까지의 합을 구하려면 다음과 같이 계산한다.
left = 1
right = 3

result = prefix[right + 1] - prefix[left]

print(result)  # 9
해당 구간의 요소는 2, 3, 4이므로 합은 9다.
누적 합 배열을 만드는 데 O(n)의 시간이 필요하지만, 생성 이후 각 구간 합 질의는 O(1)에 수행할 수 있다.
추가적인 누적 합 배열을 저장하므로 공간 복잡도는 O(n)이다.
이처럼 배열은 단순한 데이터 저장뿐만 아니라 효율적인 알고리즘을 구현하기 위한 기반으로도 활용된다.
8. 핵심 요약
이번 글에서 살펴본 내용을 정리하면 다음과 같다.
- 배열은 데이터를 일정한 순서에 따라 저장하고 인덱스로 접근하는 선형 자료구조다.
- 전통적인 배열은 동일한 크기의 요소를 연속된 메모리 공간에 저장한다.
- 배열의 인덱스 접근과 수정은 일반적으로 O(1)에 수행된다.
- 배열 중간의 삽입과 삭제는 요소 이동 때문에 O(n)의 시간이 필요할 수 있다.
- Python 리스트는 객체 참조의 동적 배열을 기반으로 구현된다.
- Python 리스트의 append()는 분할 상환 O(1)의 시간 복잡도를 가진다.
- 배열은 순서가 중요하고 특정 위치의 데이터에 자주 접근하는 상황에 적합하다.
배열은 가장 기본적인 자료구조 중 하나지만, 배열의 메모리 구조와 주요 연산의 시간 복잡도를 이해하면 다른 자료구조의 특징도 쉽게 비교할 수 있다.
특히 Python 리스트는 사용하기 편리하지만 모든 연산이 O(1)에 수행되는 것은 아니다.
따라서 어떤 위치에 접근하고, 삽입하고, 삭제하는지를 고려하여 자료구조를 선택해야 한다.
다음 글
[자료구조 07] 동적 배열(Dynamic Array)이란? Python 리스트의 크기 확장과 분할 상환 분석
다음 편에서는 이번 글에서 간단하게 살펴본 동적 배열을 더 자세히 알아본다.
동적 배열의 용량과 길이, 저장 공간 확장 과정, 재할당과 객체 참조 이동, 그리고 append()의 분할 상환 시간 복잡도를 Python 예제와 그림으로 분석한다.
자료구조 시리즈 | PART 2. 선형 자료구조 (1/12)
'자료구조 > PART 2. 선형 자료구조' 카테고리의 다른 글
| [자료구조 11] 배열과 연결 리스트 비교 — 메모리 구조, 시간 복잡도, 선택 기준 (0) | 2026.10.15 |
|---|---|
| [자료구조 10] 이중 연결 리스트와 원형 연결 리스트란? 구조와 Python 구현 (0) | 2026.10.15 |
| [자료구조 09] 단일 연결 리스트(Singly Linked List) 직접 구현하기 — 삽입, 삭제, 탐색 (0) | 2026.10.15 |
| [자료구조 08] 연결 리스트(Linked List)란? 노드와 참조, 배열과의 차이 이해하기 (0) | 2026.10.14 |
| [자료구조 07] 동적 배열(Dynamic Array)이란? Python 리스트의 크기 확장과 분할 상환 분석 (0) | 2026.10.12 |


