프로그래밍을 공부하다 보면 배열(Array), 스택(Stack), 큐(Queue), 트리(Tree), 그래프(Graph) 등의 용어를 접하게 된다.
이들은 모두 자료구조(Data Structure)의 한 종류이다.
그런데 자료구조는 왜 필요할까? 단순히 변수에 데이터를 저장하는 것과는 어떤 차이가 있을까?
이번 글에서는 자료구조의 기본 개념부터 필요성, 종류, 그리고 Python에서 사용하는 자료구조까지 알아보자.
1. 자료구조란?
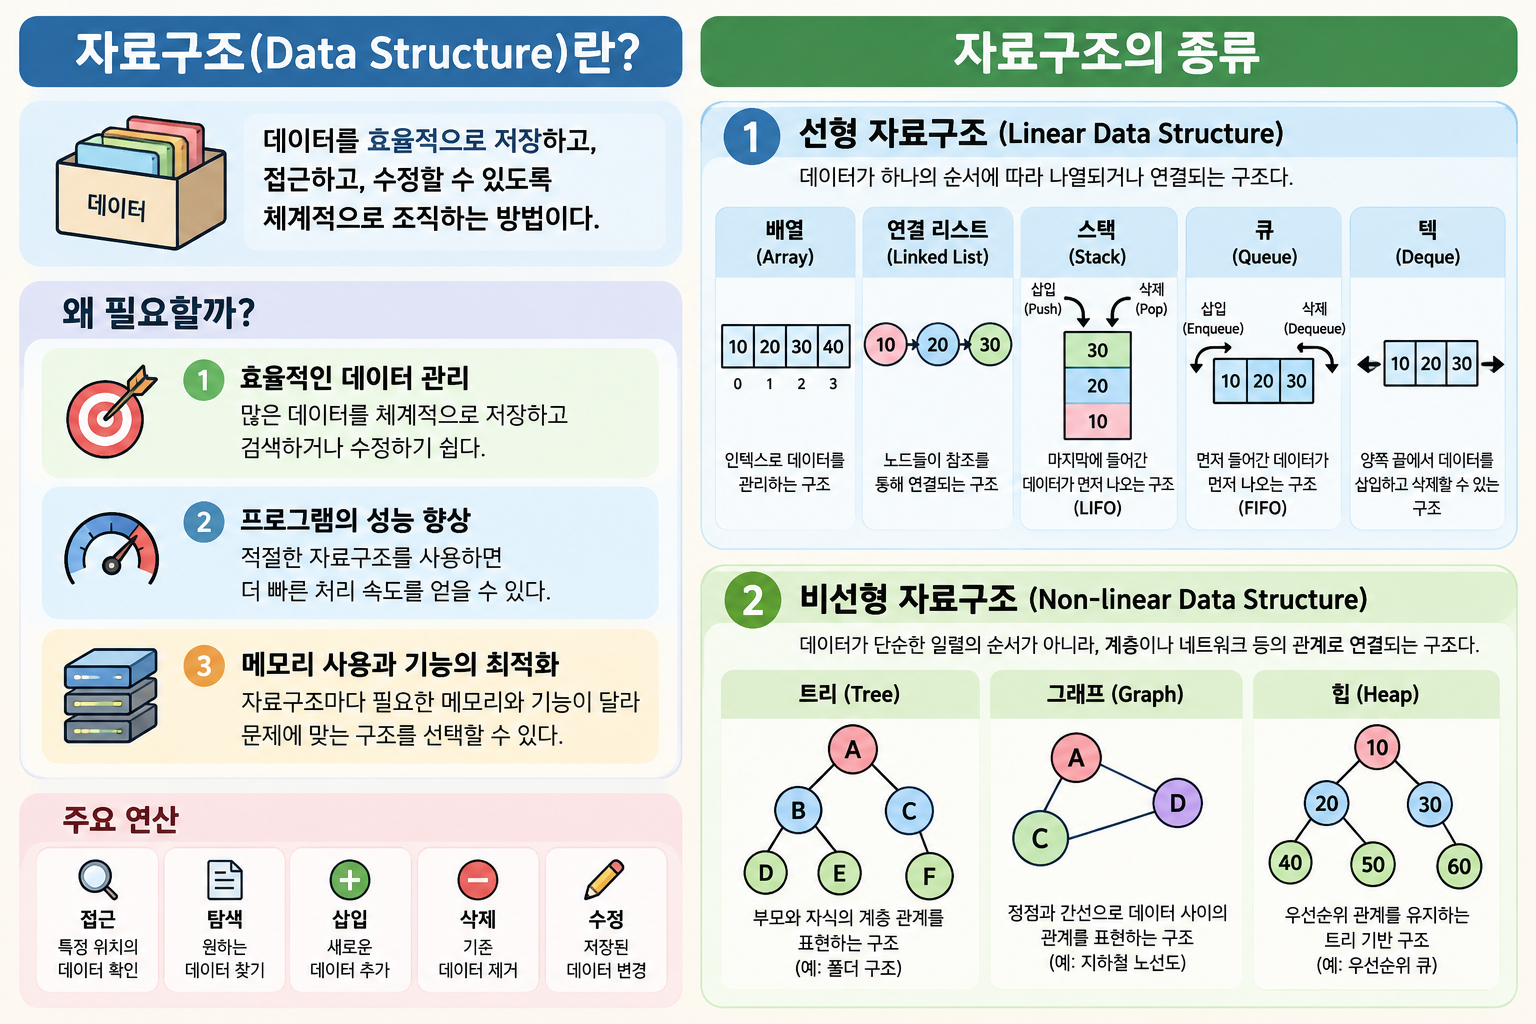
자료구조(Data Structure) 란 데이터를 효율적으로 저장하고, 접근하고, 수정할 수 있도록 체계적으로 조직하는 방법을 말한다.
프로그래밍에서는 단순히 데이터를 저장하는 것뿐만 아니라, 저장한 데이터를 검색하거나 새로운 데이터를 추가하고 삭제하는 등의 작업이 필요하다.
이때 데이터를 어떤 형태로 관리하느냐에 따라 프로그램의 동작 방식과 성능이 달라진다.
예를 들어 학생 100명의 성적을 관리하는 프로그램을 만든다고 가정해 보자.
학생마다 별도의 변수를 사용한다면 다음과 같이 작성할 수도 있다.
score1 = 90
score2 = 85
score3 = 100
하지만 학생이 100명, 1,000명으로 늘어난다면 관리하기 어려워진다.
Python의 리스트(List)를 사용하면 여러 데이터를 하나의 구조로 관리할 수 있다.
scores = [90, 85, 100]

print(scores[0])  # 90

scores.append(95)
print(scores)  # [90, 85, 100, 95]
이처럼 자료구조를 활용하면 여러 데이터를 체계적으로 관리하고, 필요한 연산을 수행하기 쉬워진다.
2. 자료구조가 필요한 이유
자료구조를 사용하는 가장 중요한 이유는 데이터를 효율적으로 처리하기 위해서다.
같은 데이터를 저장하더라도 어떤 자료구조를 선택하느냐에 따라 처리 속도와 메모리 사용량이 달라질 수 있다.
2.1. 효율적인 데이터 관리
데이터가 많아질수록 체계적인 관리가 중요해진다.
예를 들어 학생들의 이름을 저장하거나, 특정 학생의 점수를 검색하거나, 새로운 학생을 추가해야 할 수 있다.
적절한 자료구조를 사용하면 이러한 작업을 간단하게 구현할 수 있다.
2.2. 프로그램의 성능 향상
자료구조는 프로그램의 실행 속도에 직접적인 영향을 미친다.
예를 들어 리스트에서 특정 값이 존재하는지 확인하는 작업은 일반적으로 원소들을 차례로 비교해야 한다.
반면 집합(Set)은 해시를 이용하므로 평균적인 경우 더 빠른 검색이 가능하다.
단, 모든 상황에서 집합이 리스트보다 좋은 것은 아니다. 데이터의 순서나 중복 여부 등 사용 목적에 따라 적합한 자료구조가 달라진다.
2.3. 메모리 사용과 기능의 최적화
자료구조마다 데이터를 저장하는 방식과 추가로 필요한 메모리가 다르다.
또한 어떤 구조는 순서대로 데이터를 처리하기에 적합하고, 다른 구조는 데이터를 빠르게 검색하는 데 유리하다.
따라서 자료구조를 학습하면 단순히 코드가 동작하도록 만드는 것을 넘어, 문제에 적합한 방법을 선택하는 능력을 기를 수 있다.
3. 자료구조의 종류
자료구조는 대표적으로 선형 자료구조(Linear Data Structure) 와 비선형 자료구조(Non-linear Data Structure) 로 분류할 수 있다.
3.1. 선형 자료구조
선형 자료구조는 데이터가 하나의 순서에 따라 나열되거나 연결되는 구조다.
대표적인 종류는 다음과 같다.
- 배열(Array): 데이터를 인덱스를 기반으로 관리하는 구조
- 연결 리스트(Linked List): 노드들이 참조를 통해 연결되는 구조
- 스택(Stack): 마지막에 들어간 데이터가 먼저 나오는 구조
- 큐(Queue): 먼저 들어간 데이터가 먼저 나오는 구조
- 덱(Deque): 양쪽 끝에서 데이터를 삽입하고 삭제할 수 있는 구조
스택은 LIFO(Last In, First Out), 큐는 FIFO(First In, First Out) 원칙으로 동작한다.
3.2. 비선형 자료구조
비선형 자료구조는 데이터가 단순한 일렬의 순서가 아니라 계층이나 네트워크 등의 관계로 연결되는 구조다.
대표적인 종류는 다음과 같다.
- 트리(Tree): 부모와 자식의 계층 관계를 표현하는 구조
- 그래프(Graph): 정점과 간선으로 데이터 사이의 관계를 표현하는 구조
- 힙(Heap): 우선순위 관계를 유지하는 트리 기반 구조
예를 들어 컴퓨터의 폴더 구조는 트리로 표현할 수 있고, 지하철 노선도는 그래프로 표현할 수 있다.
참고로 해시 테이블(Hash Table)도 중요한 자료구조이지만, 선형과 비선형이라는 두 가지 분류만으로 모든 자료구조를 엄밀하게 구분할 수 있는 것은 아니다. 해시 테이블은 해시 함수를 이용한 데이터 관리 방식으로 별도로 공부할 예정이다.
4. 자료구조의 주요 연산과 시간 복잡도
자료구조를 비교할 때는 데이터를 어떻게 저장하는지만큼 어떤 연산을 얼마나 효율적으로 처리하는지가 중요하다.
대표적인 연산은 다음과 같다.
- 접근(Access): 특정 위치의 데이터 확인
- 탐색(Search): 원하는 데이터 찾기
- 삽입(Insertion): 새로운 데이터 추가
- 삭제(Deletion): 기존 데이터 제거
- 수정(Update): 저장된 데이터 변경
이러한 연산의 효율성을 비교할 때 시간 복잡도(Time Complexity)를 사용한다.
시간 복잡도는 입력 데이터 크기가 증가할 때 연산량이 어떻게 증가하는지 나타내는 개념이다.
예를 들어 Python 리스트에서 인덱스로 원소에 접근하는 작업은 일반적으로 O(1)이며, 특정 값을 처음부터 검색하는 작업은 O(n)이다.
여기서 n은 데이터의 개수를 의미한다.
시간 복잡도의 정확한 의미와 Big-O 표기법은 다음 편에서 자세히 알아본다.
5. Python에서 사용하는 자료구조
Python은 여러 자료구조를 기본적으로 제공하므로 복잡한 구조를 직접 구현하지 않고도 활용할 수 있다.
5.1. 리스트(List)
리스트는 여러 값을 순서대로 저장하며, 값의 추가와 삭제가 가능하다.
numbers = [10, 20, 30]

numbers.append(40)
print(numbers)  # [10, 20, 30, 40]

numbers.pop()
print(numbers)  # [10, 20, 30]
Python의 리스트는 내부적으로 동적 배열을 기반으로 구현되어 있다.
5.2. 딕셔너리(Dictionary)
딕셔너리는 키(Key)와 값(Value)을 연결해서 데이터를 저장하는 자료구조다.
student = {
    "name": "Kim",
    "score": 95
}

print(student["name"])  # Kim
print(student["score"])  # 95
딕셔너리는 해시 테이블을 기반으로 하며, 일반적인 경우 키를 이용한 빠른 검색이 가능하다.
5.3. 집합(Set)
집합은 중복된 원소를 허용하지 않는 자료구조다.
numbers = {1, 2, 2, 3, 3, 4}

print(numbers == {1, 2, 3, 4})  # True
print(3 in numbers)             # True
중복된 데이터를 제거하거나 특정 값의 존재 여부를 확인하는 상황에서 유용하다.
5.4. 큐(Queue)
Python에서는 collections 모듈의 deque를 이용하여 큐를 효율적으로 구현할 수 있다.
from collections import deque

queue = deque()

queue.append(10)
queue.append(20)
queue.append(30)

print(queue.popleft())  # 10
print(queue.popleft())  # 20
먼저 삽입한 10이 먼저 제거된다는 점에서 FIFO 구조를 확인할 수 있다.
6. 자료구조의 장단점과 선택 기준
모든 상황에서 가장 좋은 자료구조는 존재하지 않는다.
예를 들어 리스트는 인덱스로 데이터에 접근하기 편리하지만, 맨 앞에 데이터를 반복적으로 추가하거나 삭제하면 많은 원소를 이동시켜야 할 수 있다.
반면 deque는 양쪽 끝에서 데이터를 추가하고 제거하는 작업을 효율적으로 처리한다.
딕셔너리는 키로 데이터를 조회하기 좋고, 집합은 중복을 방지하거나 데이터의 존재 여부를 확인할 때 유용하다.
중요한 것은 현재 해결하려는 문제에 어떤 연산이 필요한지 먼저 파악하는 것이다.
7. 코딩 테스트에서 자료구조가 중요한 이유
코딩 테스트에서는 올바른 결과를 구하는 것뿐만 아니라 제한된 시간과 메모리 안에서 문제를 해결해야 한다.
예를 들어 다음과 같은 문제를 생각해 볼 수 있다.
문제: 숫자들이 주어졌을 때 특정 숫자가 존재하는지 여러 번 확인해야 한다.
단순히 리스트를 사용하면 다음과 같이 작성할 수 있다.
numbers = [1, 3, 5, 7, 9]

print(5 in numbers)  # True
하지만 데이터가 매우 많고 같은 검색을 반복해야 한다면 집합을 사용하는 것이 유리할 수 있다.
numbers = {1, 3, 5, 7, 9}

print(5 in numbers)  # True
리스트의 포함 여부 검사는 일반적으로 O(n)이지만, 집합의 포함 여부 검사는 평균적으로 O(1)이다.
물론 집합을 만드는 시간과 추가 메모리 사용량도 고려해야 한다.
이처럼 자료구조에 대한 이해는 코딩 테스트에서 더 효율적인 해결 방법을 찾는 데 중요한 역할을 한다.
8. 핵심 요약
이번 글에서 살펴본 내용을 정리하면 다음과 같다.
- 자료구조는 데이터를 효율적으로 저장하고 관리하기 위한 구조다.
- 자료구조에 따라 데이터 접근, 탐색, 삽입, 삭제의 효율성이 달라진다.
- 대표적인 분류로 선형 자료구조와 비선형 자료구조가 있다.
- Python은 리스트, 딕셔너리, 집합, 덱 등 다양한 자료구조를 제공한다.
- 적절한 자료구조를 선택하는 능력은 알고리즘과 코딩 테스트에서 중요하다.
자료구조는 단순히 암기하는 대상이 아니라, 데이터가 어떻게 저장되고 어떤 연산이 필요한지 이해하면서 익혀야 하는 개념이다.
앞으로 각 자료구조의 동작 원리와 시간 복잡도를 살펴보고, Python으로 직접 구현해 본다.
다음 글
[자료구조 02] 시간 복잡도와 공간 복잡도란? Big-O 표기법 이해하기
다음 편에서는 알고리즘과 자료구조의 성능을 분석하는 데 사용되는 시간 복잡도와 공간 복잡도를 알아본다.
특히 O(1), O(log n), O(n), O(n²) 등의 의미를 Python 코드와 그림을 통해 설명한다.
자료구조 시리즈 | PART 1. 자료구조 기초 (1/5)
'자료구조 > PART 1. 자료구조 기초' 카테고리의 다른 글
| [자료구조 05] 재귀 함수란? 호출 스택과 종료 조건 이해하기 (0) | 2026.10.12 |
|---|---|
| [자료구조 04] 추상 자료형(ADT)이란? 자료구조와의 차이 이해하기 (0) | 2026.10.12 |
| [자료구조 03] 메모리 구조란? 스택과 힙 메모리, Python의 객체와 참조 이해하기 (0) | 2026.10.12 |
| [자료구조 02] 시간 복잡도와 공간 복잡도란? Big-O 표기법 이해하기 (0) | 2026.10.12 |


