자료구조를 공부하다 보면 배열(Array), 연결 리스트(Linked List), 스택(Stack), 큐(Queue) 등 다양한 개념을 접하게 된다.
그런데 스택과 큐를 설명할 때는 추상 자료형(Abstract Data Type, ADT) 이라는 용어도 자주 등장한다.
자료구조와 추상 자료형은 밀접하게 관련되어 있지만 완전히 같은 개념은 아니다.
이 둘의 차이를 이해하면 자료구조를 단순히 사용하는 것을 넘어, 직접 설계하고 구현하는 데 필요한 기초를 익힐 수 있다.
이번 글에서는 추상 자료형의 개념과 필요성, 자료구조와의 차이를 알아보고 Python으로 스택과 큐를 구현해 본다.
1. 추상 자료형(ADT)이란?
추상 자료형(Abstract Data Type, ADT) 은 데이터의 형태와 데이터에 대해 수행할 수 있는 연산, 그리고 연산의 동작 규칙을 정의한 추상적인 모델이다.
쉽게 말하면 데이터를 어떻게 구현하는지보다 무엇을 할 수 있는지에 집중한 개념이다.
예를 들어 스택(Stack)이라는 구조를 생각해 보자.
스택은 다음과 같은 동작을 수행할 수 있어야 한다.
- 새로운 데이터를 맨 위에 삽입한다.
- 가장 위에 있는 데이터를 제거한다.
- 가장 위에 있는 데이터를 확인한다.
- 스택이 비어 있는지 확인한다.
여기서 중요한 점은 이러한 동작을 어떤 코드로 구현하는지까지 정의할 필요는 없다는 것이다.
배열을 사용할 수도 있고, 연결 리스트를 사용할 수도 있다.
어떤 방식으로 구현하더라도 스택의 핵심 동작과 규칙을 만족한다면 스택 ADT의 구현이라고 볼 수 있다.
즉, ADT는 연산의 의미와 동작 규칙을 정의하고, 자료구조는 해당 연산을 실제 데이터 저장 방식과 알고리즘으로 구현하는 데 초점을 맞춘다.
2. ADT와 자료구조의 차이
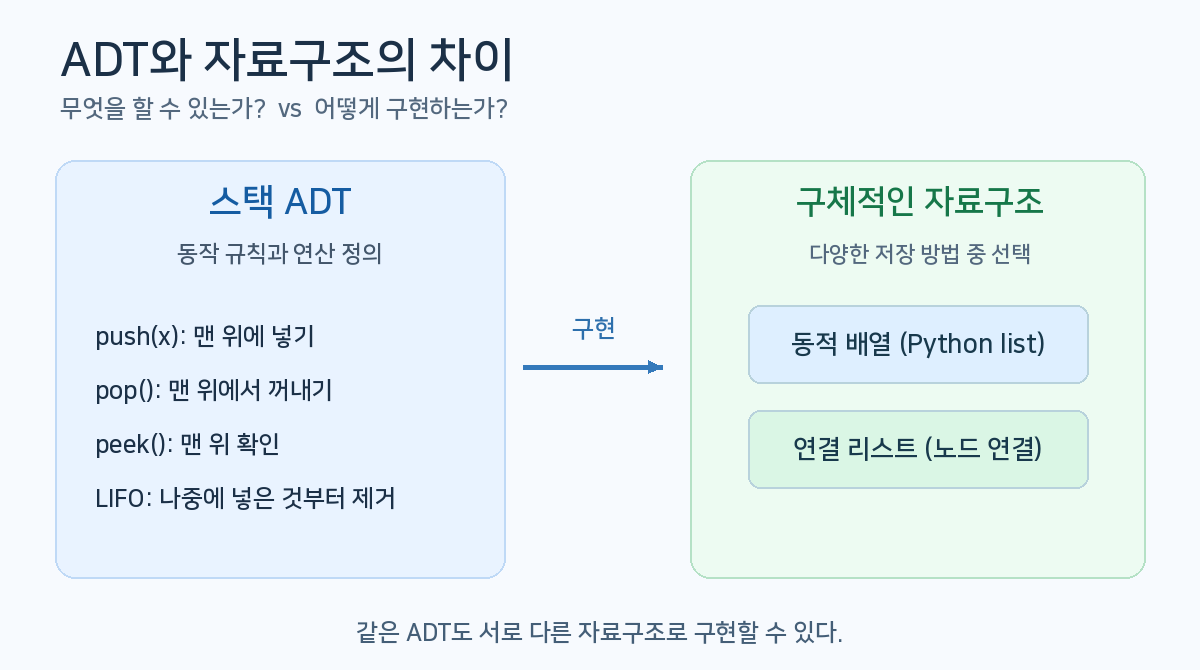
ADT와 자료구조의 차이는 무엇을 할 수 있는가(What) 와 어떻게 구현하는가(How) 로 이해할 수 있다.
구분추상 자료형(ADT)자료구조(Data Structure)
| 목적 | 데이터와 연산의 규칙 정의 | 데이터 저장과 연산 구현 |
| 핵심 질문 | 무엇을 할 수 있는가? | 어떻게 구현하는가? |
| 관심 대상 | 연산의 의미, 동작 규칙 | 메모리 배치, 연결 구조, 알고리즘 |
| 구현 방법 | 특정 구현에 종속되지 않음 | 구체적인 구현 방식 필요 |
| 대표적인 예 | 스택 ADT, 큐 ADT | 동적 배열, 연결 리스트 |
예를 들어 스택 ADT가 있다고 가정하자.
스택 ADT는 push(), pop(), peek() 등의 연산을 정의한다.
이 연산들은 Python 리스트로도 구현할 수 있고 연결 리스트로도 구현할 수 있다.
두 구현의 내부 구조는 다르지만, 사용자에게 제공하는 연산과 동작 규칙은 동일할 수 있다.
2.1. ADT가 필요한 이유
ADT를 사용하는 가장 큰 이유는 구현 세부 사항과 외부에서 사용하는 기능을 분리하기 위해서다.
예를 들어 프로그램에서 스택을 사용한다고 가정해 보자.
스택을 사용하는 코드는 다음과 같은 동작만 알면 된다.
stack.push(10)
stack.push(20)

print(stack.pop())  # 20
스택의 내부 저장소가 배열인지 연결 리스트인지는 알 필요가 없다.
나중에 내부 구현 방식을 변경하더라도 push()와 pop()의 의미가 유지된다면 외부 코드를 크게 수정하지 않고 사용할 수 있다.
이러한 설계 방식은 프로그램의 유지보수성과 재사용성을 높이는 데 도움이 된다.
3. ADT의 주요 연산과 동작 원리
ADT는 데이터의 종류에 따라 제공하는 연산과 동작 규칙이 달라진다.
대표적인 예시인 스택과 큐를 살펴보자.
3.1. 스택(Stack) ADT
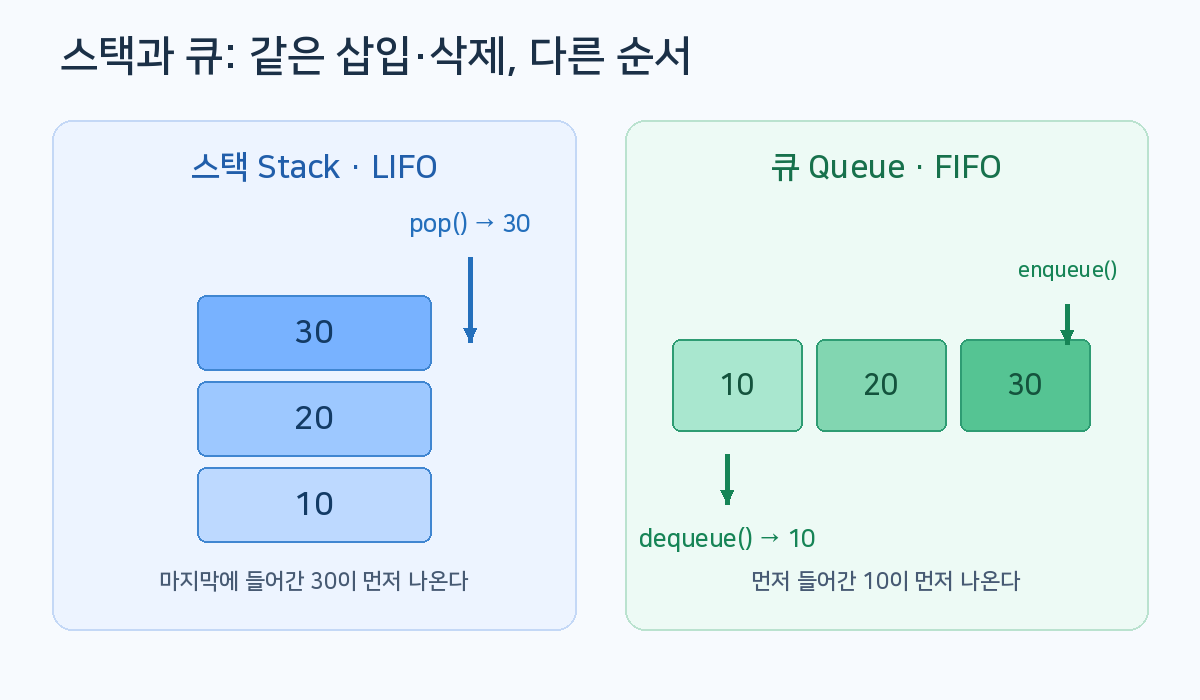
스택은 LIFO(Last In, First Out) 원칙에 따라 동작하는 ADT다.
마지막에 삽입한 데이터가 가장 먼저 제거된다.
대표적인 연산은 다음과 같다.
연산기능
| push(x) | 데이터 x를 스택의 맨 위에 삽입 |
| pop() | 맨 위의 데이터 제거 및 반환 |
| peek() | 맨 위의 데이터 확인 |
| is_empty() | 스택이 비어 있는지 확인 |
| size() | 저장된 데이터 개수 반환 |
예를 들어 빈 스택에 10, 20, 30을 순서대로 삽입하면 다음과 같다.
push(10) → [10]
push(20) → [10, 20]
push(30) → [10, 20, 30]
이후 pop()을 호출하면 마지막에 삽입한 30이 먼저 제거된다.
pop() → 30
남은 스택 → [10, 20]
스택의 중요한 특징은 데이터를 맨 위에서만 삽입하거나 제거한다는 점이다.
3.2. 큐(Queue) ADT
큐는 FIFO(First In, First Out) 원칙에 따라 동작하는 ADT다.
먼저 삽입한 데이터가 먼저 제거된다.
대표적인 연산은 다음과 같다.
연산기능
| enqueue(x) | 데이터 x를 큐의 뒤쪽에 삽입 |
| dequeue() | 큐의 앞쪽 데이터 제거 및 반환 |
| front() | 큐의 앞쪽 데이터 확인 |
| is_empty() | 큐가 비어 있는지 확인 |
| size() | 저장된 데이터 개수 반환 |
예를 들어 빈 큐에 10, 20, 30을 순서대로 삽입하면 다음과 같다.
enqueue(10) → [10]
enqueue(20) → [10, 20]
enqueue(30) → [10, 20, 30]
이후 dequeue()를 호출하면 가장 먼저 삽입한 10이 제거된다.
dequeue() → 10
남은 큐 → [20, 30]
이처럼 스택과 큐는 데이터를 삽입하고 제거하는 규칙에서 차이가 있다.
4. ADT를 구현하는 방법과 시간 복잡도
동일한 ADT도 어떤 자료구조를 사용하느냐에 따라 성능이 달라질 수 있다.
4.1. 스택의 구현 방법
스택은 동적 배열이나 연결 리스트를 사용하여 구현할 수 있다.
Python 리스트를 사용하는 경우 맨 뒤에 데이터를 추가하는 append()와 마지막 원소를 제거하는 pop()을 이용한다.
두 연산 모두 일반적인 스택 동작에 적합하다.
구현 방식pushpop
| Python list | 분할 상환 O(1) | O(1) |
| 단일 연결 리스트(머리 노드 사용) | O(1) | O(1) |
Python 리스트의 append()는 내부 저장 공간이 부족할 때 재할당이 발생할 수 있으므로 분할 상환 O(1)로 분석한다.
4.2. 큐의 구현 방법
큐 역시 배열이나 연결 리스트로 구현할 수 있다.
하지만 Python 리스트에서 pop(0)을 사용하면 맨 앞의 원소를 제거한 후 나머지 원소들을 이동시켜야 한다.
따라서 시간 복잡도는 O(n)이다.
반면 collections.deque는 양쪽 끝에서 데이터를 추가하고 제거하는 작업을 O(1)에 수행할 수 있도록 설계되어 있다.
구현 방식enqueuedequeue
| Python list (append, pop(0)) | 분할 상환 O(1) | O(n) |
| collections.deque | O(1) | O(1) |
| 연결 리스트(머리·꼬리 관리) | O(1) | O(1) |
같은 큐 ADT라도 구현 방식에 따라 시간 복잡도가 달라진다는 사실을 확인할 수 있다.
5. Python으로 ADT 직접 구현하기
Python에서는 클래스를 이용하여 ADT에서 정의한 연산을 외부에 제공하고, 내부 저장 방식은 감추는 형태로 구현할 수 있다.
5.1. 리스트를 이용한 스택 구현
class Stack:
    def __init__(self):
        self._items = []

    def push(self, value):
        self._items.append(value)

    def pop(self):
        if self.is_empty():
            raise IndexError("스택이 비어 있다.")
        return self._items.pop()

    def peek(self):
        if self.is_empty():
            raise IndexError("스택이 비어 있다.")
        return self._items[-1]

    def is_empty(self):
        return len(self._items) == 0

    def size(self):
        return len(self._items)


stack = Stack()

stack.push(10)
stack.push(20)
stack.push(30)

print(stack.peek())      # 30
print(stack.pop())       # 30
print(stack.size())      # 2
print(stack.is_empty())  # False
이 코드에서 _items는 스택의 내부 저장소다.
앞에 붙은 밑줄(_)은 외부에서 직접 접근하지 않는 내부 구현 요소라는 관례를 나타낸다. Python에서 접근을 강제로 차단하는 문법은 아니다.
사용자는 _items를 직접 조작하는 대신 push(), pop(), peek() 등의 메서드를 사용한다.
이렇게 하면 스택의 사용 방법과 내부 구현을 분리할 수 있다.
5.2. deque를 이용한 큐 구현
from collections import deque


class Queue:
    def __init__(self):
        self._items = deque()

    def enqueue(self, value):
        self._items.append(value)

    def dequeue(self):
        if self.is_empty():
            raise IndexError("큐가 비어 있다.")
        return self._items.popleft()

    def front(self):
        if self.is_empty():
            raise IndexError("큐가 비어 있다.")
        return self._items[0]

    def is_empty(self):
        return len(self._items) == 0

    def size(self):
        return len(self._items)


queue = Queue()

queue.enqueue(10)
queue.enqueue(20)
queue.enqueue(30)

print(queue.front())     # 10
print(queue.dequeue())   # 10
print(queue.size())      # 2
print(queue.is_empty())  # False
큐 역시 enqueue(), dequeue() 등의 연산을 외부에 제공한다.
내부 저장소는 deque를 사용하지만, 외부에서는 큐의 동작 규칙만 알면 사용할 수 있다.
이처럼 ADT가 정의한 동작을 클래스의 메서드로 구현하고, 실제 데이터는 적절한 자료구조에 저장할 수 있다.
단, Python 클래스 자체가 곧 ADT인 것은 아니다. 클래스는 ADT를 구현하기 위한 한 가지 수단이다.
6. ADT의 장단점과 활용 상황
ADT는 자료구조를 설계하고 사용하는 데 여러 장점을 제공한다.
6.1. 장점
첫째, 구현 방식과 사용 방법을 분리할 수 있다.
사용자는 내부 저장 구조를 몰라도 정의된 연산을 통해 데이터를 다룰 수 있다.
둘째, 코드의 재사용성을 높일 수 있다.
스택이나 큐처럼 동작이 명확하게 정의된 인터페이스를 여러 프로그램에서 재사용할 수 있다.
셋째, 유지보수가 쉬워진다.
내부 구현 방식을 변경하더라도 외부에 제공하는 연산의 의미를 유지하면 기존 코드를 그대로 사용할 수 있다.
넷째, 프로그램의 구조를 명확하게 설계할 수 있다.
데이터에 어떤 연산이 필요한지 먼저 정의하므로 구현 이전에 프로그램의 요구사항을 정리하기 좋다.
6.2. 한계 및 주의점
ADT는 연산의 의미를 정의하지만, 구체적인 성능까지 자동으로 보장하지는 않는다.
예를 들어 동일한 큐 ADT라도 Python 리스트로 구현한 경우와 deque로 구현한 경우의 삭제 성능은 다르다.
또한 ADT를 클래스로 구현한다고 해서 모든 데이터가 외부로부터 완전히 보호되는 것은 아니다.
Python에서 객체의 내부 상태를 숨기는 것은 주로 관례와 인터페이스 설계에 의존한다.
따라서 ADT를 사용할 때는 연산의 의미뿐만 아니라 실제 구현의 시간 복잡도와 메모리 사용량도 함께 고려해야 한다.
7. 코딩 테스트에서 ADT 활용하기
코딩 테스트에서는 스택과 큐의 내부 구조를 직접 구현하지 않더라도 ADT의 동작 규칙을 이해하고 적절하게 적용하는 능력이 중요하다.
7.1. 스택 활용 — 올바른 괄호
괄호 문자열이 올바르게 열리고 닫히는지 확인하는 문제에서는 스택을 활용할 수 있다.
열린 괄호 (를 만나면 스택에 삽입하고, 닫힌 괄호 )를 만나면 스택에서 하나를 제거한다.
def solution(s):
    stack = []

    for char in s:
        if char == "(":
            stack.append(char)
        else:
            if not stack:
                return False
            stack.pop()

    return not stack


print(solution("(())()"))  # True
print(solution("(()"))     # False
print(solution("())("))    # False
이 코드는 문자열에 (와 )만 포함된다는 조건을 전제로 한다.
문자열의 각 문자를 한 번씩 확인하므로 시간 복잡도는 O(n)이다.
스택에 최대 n개의 열린 괄호가 저장될 수 있으므로 공간 복잡도는 O(n)이다.
7.2. 큐 활용 — 작업 처리
먼저 들어온 작업을 먼저 처리해야 하는 경우에는 큐를 사용할 수 있다.
from collections import deque

tasks = deque(["작업 A", "작업 B", "작업 C"])

while tasks:
    current = tasks.popleft()
    print(f"{current} 처리")
실행 결과는 다음과 같다.
작업 A 처리
작업 B 처리
작업 C 처리
작업은 큐에 들어온 순서대로 처리된다.
이와 같은 FIFO 동작은 BFS(너비 우선 탐색), 작업 스케줄링, 대기열 처리 등 다양한 상황에서 활용된다.
코딩 테스트에서는 ADT의 연산을 이해한 후 Python에서 효율적인 구현을 선택하는 것이 중요하다.
8. 핵심 요약
이번 글에서 살펴본 내용을 정리하면 다음과 같다.
- 추상 자료형(ADT)은 데이터와 연산의 의미 및 동작 규칙을 정의한 추상적인 모델이다.
- ADT는 무엇을 할 수 있는지에 집중하며, 자료구조는 데이터를 어떻게 저장하고 연산을 구현할지에 집중한다.
- 스택 ADT는 LIFO, 큐 ADT는 FIFO 규칙에 따라 동작한다.
- 동일한 ADT를 배열이나 연결 리스트처럼 서로 다른 자료구조로 구현할 수 있다.
- 구현 방식에 따라 시간 복잡도와 공간 복잡도가 달라질 수 있다.
- Python에서는 클래스와 기본 자료구조를 활용하여 ADT를 구현할 수 있다.
- ADT의 개념을 이해하면 자료구조를 설계하고 적절하게 선택하는 데 도움이 된다.
자료구조를 공부할 때는 단순히 구현 코드를 외우는 것보다 해당 자료구조가 어떤 연산을 제공해야 하는지 먼저 이해하는 것이 중요하다.
ADT는 연산의 명세를 정의하고, 자료구조는 그 명세를 실제로 구현한다.
이 차이를 이해하면 이후 스택, 큐, 연결 리스트, 트리 등의 구조를 공부할 때 구현 방법과 동작 원리를 명확하게 구분할 수 있다.
다음 글
[자료구조 05] 재귀 함수란? 호출 스택과 종료 조건 이해하기
다음 편에서는 함수가 자기 자신을 다시 호출하는 재귀(Recursion)의 개념을 알아본다.
특히 재귀 함수의 종료 조건과 호출 스택의 변화, 반복문과 재귀 함수의 차이, 시간 복잡도와 공간 복잡도를 Python 예제와 그림을 통해 살펴본다.
자료구조 시리즈 | PART 1. 자료구조 기초 (4/5)
'자료구조 > PART 1. 자료구조 기초' 카테고리의 다른 글
| [자료구조 05] 재귀 함수란? 호출 스택과 종료 조건 이해하기 (0) | 2026.10.12 |
|---|---|
| [자료구조 03] 메모리 구조란? 스택과 힙 메모리, Python의 객체와 참조 이해하기 (0) | 2026.10.12 |
| [자료구조 02] 시간 복잡도와 공간 복잡도란? Big-O 표기법 이해하기 (0) | 2026.10.12 |
| [자료구조 01] 자료구조(Data Structure)란? 개념부터 종류까지 (0) | 2026.10.12 |


